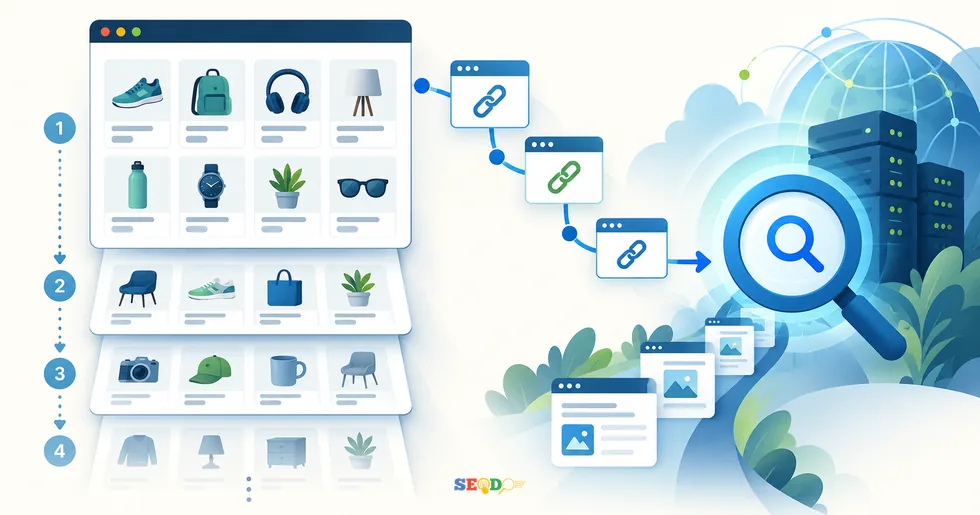
اسکرول بینهایت و دکمهٔ «نمایش بیشتر» میتوانند مرور فهرست محصولات یا مقالهها را برای کاربر راحت کنند، اما کشف محتوای بعدی نباید به اسکرول یا کلیک وابسته بماند. برای هر بخش، نشانی پایدار و صفحهٔ قابل بارگذاری مستقیم بسازید و میان بخشها لینک واقعی قرار دهید. جاوااسکریپت فقط تجربهٔ پیمایش را بهتر کند.
در یک دستهٔ فروشگاهی، کاربر چند محصول اول را میبیند و با پایین رفتن صفحه، محصولات بعدی ظاهر میشوند. این تجربه ممکن است روان باشد، اما ظاهرشدن محصول در مرورگر کاربر به این معنی نیست که خزنده هم مسیر رسیدن به آن را پیدا میکند. اگر تنها راه دیدن بخش دوم، کلیک روی دکمه یا رسیدن به انتهای صفحه باشد، بخشی از فهرست ممکن است از مسیرهای معمول کشف URL بیرون بماند.
راهحل، حذف اسکرول بینهایت نیست. باید زیر این تجربه، یک ساختار صفحهدار با URLهای مستقل وجود داشته باشد. این مقاله فقط دربارهٔ پیادهسازی و آزمون اسکرول بینهایت و Load More است؛ برای تصمیمهای عمومی دربارهٔ شمارهگذاری صفحهها، ترتیب لینکها و معماری صفحهبندی، راهنمای سئو صفحهبندی را بخوانید.
گوگل در اسکرول بینهایت چه چیزی را از دست میدهد؟
گوگل برای کشف صفحههای تازه، لینکهای دارای href را از HTML و نسخهٔ رندرشده استخراج میکند. خزنده برای دیدن محتوای بیشتر مثل کاربر دکمه را فشار نمیدهد و لزوماً تا انتهای فهرست اسکرول نمیکند. پس محصولی که فقط پس از رویداد کلیک یا اسکرول وارد صفحه میشود، ممکن است مسیر کشف قابل اتکایی نداشته باشد.
این مشکل را باید از «رندر جاوااسکریپت» جدا کرد. گوگل میتواند بسیاری از صفحههای جاوااسکریپتی را رندر کند، ولی اجرای کد تضمین نمیکند که همهٔ رویدادهای تعاملی کاربر رخ دهند. اگر کد شما درخواست بخش بعدی را فقط در تابع onClick یا بعد از رسیدن کاربر به انتهای صفحه میفرستد، وجود رندرکنندهٔ جاوااسکریپت بهتنهایی کافی نیست. راهنمای رسمی گوگل دربارهٔ بارگذاری تنبل نیز همین تمایز را روشن میکند.
یک نشانهٔ ساده در بررسی اولیه این است: لینک صفحهٔ دسته را در مرورگر ناشناس باز کنید، بدون اسکرول و کلیک به کد صفحه نگاه کنید و ببینید آیا راهی برای رسیدن به بخش بعدی هست یا نه. نبودن لینک به معنای حکم قطعی دربارهٔ ایندکسنشدن همهٔ محصولات نیست؛ محصول ممکن است از sitemap یا دستهای دیگر کشف شود. بااینحال، فهرست نباید برای کشف اقلامش به شانس و مسیرهای جانبی تکیه کند.
ساختار پایه: هر بخش یک URL پایدار و قابل باز شدن
برای بخشهای فهرست، نشانیهایی مانند /shop/shoes/?page=2 و /shop/shoes/?page=3 بسازید. هر نشانی باید هنگام باز شدن مستقیم، همان بخش از محصولات را نشان دهد و پاسخ معتبر برگرداند. اگر کاربر لینک بخش سوم را برای فرد دیگری بفرستد یا صفحه را تازهسازی کند، نباید به ابتدای فهرست برگردد.
شمارهٔ مطلق صفحه برای این کار از نشانیهای وابسته به زمان یا وضعیت جلسه بهتر است. آدرسی مثل ?page=3 معنا و محتوای نسبتاً پایداری دارد، درحالیکه ?after=last-seen-item ممکن است با تغییر موجودی یا نشست کاربر نامعتبر شود. پایداری به معنای ثابت ماندن ابدی تکتک محصولات نیست؛ یعنی URL همچنان جای مشخصی در ترتیب فهرست داشته باشد و هر بار با ساختاری قابل فهم باز شود.
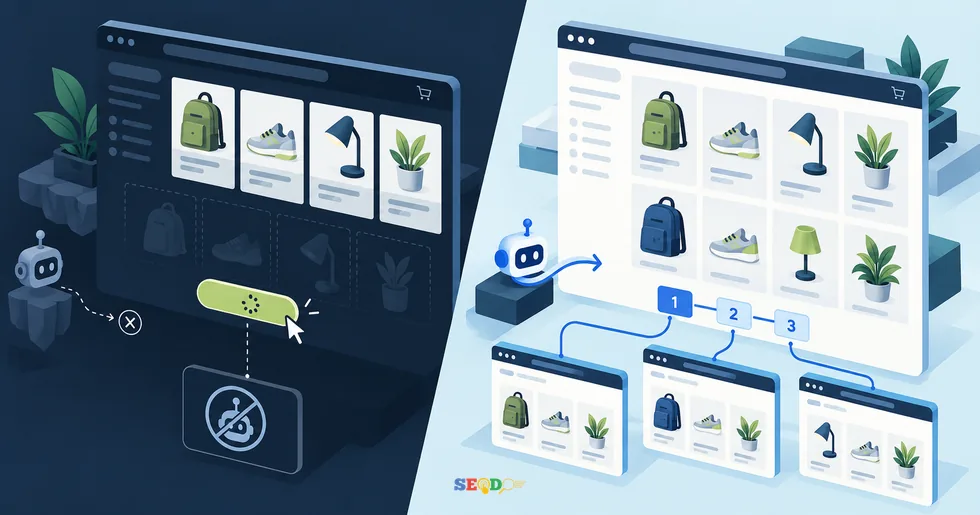
در صفحهٔ اول، یک لینک واقعی به صفحهٔ دوم بگذارید و در صفحهٔ دوم نیز به صفحهٔ بعدی راه بدهید. شکل سادهٔ آن <a href="/shop/shoes/?page=2">محصولات بیشتر</a> است. اگر برای کاربر دکمه نمایش میدهید، میتوانید ظاهر همین لینک را شبیه دکمه طراحی کنید و با جاوااسکریپت رفتار نرمتر به آن بدهید. اما مسیر HTML باید بدون تکیه به onclick هم کار کند.
در پروژههای خدمات سئو سایت، این بخش معمولاً با همکاری توسعهدهنده و کارشناس سئو بررسی میشود: توسعهدهنده خروجی واقعی URLها و لینکها را میسازد و کارشناس سئو بررسی میکند که خزنده به اقلام مهم برسد. تغییر ظاهری دکمه، بدون آزمون پاسخ مستقیم صفحههای بعدی، مشکل کشف را حل نمیکند.
دکمهٔ «نمایش بیشتر» چگونه پیادهسازی شود؟
دکمهٔ Load More برای کاربر میتواند اقلام بعدی را بدون بارگذاری کامل صفحه اضافه کند؛ اما پشت آن باید لینک صفحهٔ بعدی وجود داشته باشد. راه عملی این است که عنصر اصلی یک لینک با href باشد، سپس جاوااسکریپت روی کلیک آن درخواست AJAX بفرستد و نتیجه را به فهرست فعلی بچسباند. اگر جاوااسکریپت اجرا نشد، خود لینک کاربر را به صفحهٔ بعدی ببرد.
این روش «بهبود تدریجی» یک فایدهٔ دیگر هم دارد: آزمونپذیر است. وقتی جاوااسکریپت را خاموش میکنید، هنوز میتوانید از صفحهٔ اول به دوم بروید و محصولات را ببینید. اگر کل فهرست بعد از خاموش کردن اسکریپت ناپدید میشود، باید بررسی کنید آیا HTML رندرشدهٔ گوگل واقعاً محتوای ضروری را دریافت میکند یا خیر.
برای هر محصول نیز لینک خود محصول را با عنصر a و href واقعی بسازید. کارت محصولی که فقط با رویداد کلیک روی یک div باز میشود، مسیر روشنی برای خزنده نمیدهد. متن لینک بهتر است نام محصول یا موضوع را بیان کند؛ «مشاهده» بهتنهایی اطلاعات کمی درباره مقصد دارد. راهنمای لینکهای قابل خزش گوگل نمونههای قابل قبول و نامطمئن را نشان میدهد.
اسکرول بینهایت چه تفاوتی در اجرا دارد؟
در اسکرول بینهایت، بارگذاری بخش بعدی با رسیدن محتوای فعلی به محدودهٔ دید آغاز میشود. این رفتار برای کاربر خودکار است، ولی همچنان باید روی همان URLهای صفحهدار و لینکهای متوالی سوار شود. IntersectionObserver میتواند محرک بارگذاری باشد؛ کارکرد آن جایگزین لینکهای قابل خزش نیست.
وقتی بخش تازه به بخش اصلی قابل مشاهدهٔ صفحه تبدیل میشود، میتوان با History API نشانی نمایشدادهشده را به URL همان بخش تغییر داد. با این کار، تازهسازی، اشتراکگذاری و دکمهٔ بازگشت مرورگر معنای روشنتری دارند. تغییر URL نباید زودتر از نمایش واقعی بخش یا برای هر پیکسل اسکرول انجام شود؛ در غیر این صورت تاریخچهٔ مرورگر شلوغ میشود و کاربر به جای نامنتظره برمیگردد.
نمونهٔ قابل سنجش این است: کاربر به محصولات صفحهٔ سوم میرسد، نوار نشانی ?page=3 را نشان میدهد و با تازهسازی همان صفحه، بخش سوم مستقیم بارگذاری میشود. اگر پس از تازهسازی صفحهٔ اول ظاهر شود، URL فقط ظاهری تغییر کرده و مسیر مستقل برای بخش سوم وجود ندارد. این یکی از خطاهای رایج در پیادهسازیهای ظاهراً کامل است.
برای فهرستهای بسیار بلند، محدود کردن تعداد اقلامی که همزمان در DOM میمانند میتواند به کارایی کمک کند؛ اما حذف اقلام قدیمی از DOM نباید لینکهای لازم برای پیمایش را از بین ببرد. کاربر و خزنده باید بتوانند از هر URL صفحهدار به بخشهای مجاور برسند. اگر مسیر فقط در حافظهٔ جاوااسکریپت نگه داشته شود، باز کردن مستقیم URL یا بازگشت در مرورگر ممکن است شکست بخورد.
canonical و صفحههای بعدی را چگونه تنظیم کنیم؟
صفحهٔ دوم و سوم اگر اقلام متفاوتی دارند، محتوای یکسان با صفحهٔ اول نیستند. در این حالت نباید همهٔ آنها را بدون بررسی به صفحهٔ اول canonical کنید. چنین کاری به گوگل میگوید نسخههای بعدی جایگزین صفحهٔ اولاند و میتواند برداشت از محتوای مستقل آنها را محدود کند. راهنمای صفحهبندی فروشگاهی گوگل تأکید میکند URLهای صفحهدار جداگانه دیده میشوند.
برای صفحههای ارزشمند و قابل ایندکس، canonical خودارجاع و URL سازگار به کار ببرید. برای مثال، تصمیم بگیرید صفحهٔ اول همیشه /shop/shoes/ باشد یا ?page=1 و همان قاعده را در لینکها و canonical حفظ کنید. پارامترهای مرتبسازی و فیلتر داستان دیگری دارند؛ ایجاد بیحساب ترکیبهای رنگ، سایز و ترتیب نمایش میتواند URLهای کمارزش زیادی بسازد. این مقاله وارد سیاست کامل فیلترها نمیشود، اما هنگام آزمون باید مطمئن شوید صفحهبندی پایه با پارامترهای فیلتر اشتباه گرفته نمیشود.
noindex کردن همهٔ صفحههای بعدی نیز نسخهٔ عمومی برای همهٔ سایتها نیست. اگر هدف، کشف اقلام و مسیرهای دسته است، باید اثر چنین تصمیمی روی راههای دسترسی و ارزش همان صفحهها بررسی شود. ابتدا ساختار فهرست، تعداد اقلام، لینکهای مستقیم محصول و رفتار واقعی گوگل را ببینید؛ بعد برای ایندکس یا عدم ایندکس تصمیم بگیرید.
تصویر و کارت محصول چه اثری بر کشف محتوا دارند؟
بارگذاری تنبل تصویر با بارگذاری تنبل کل کارت محصول یکی نیست. میتوانید تصویر پایین صفحه را دیرتر دریافت کنید، اما نام و لینک محصول باید در ساختار قابل مشاهدهٔ صفحه حضور داشته باشند یا از URL بخش بعدی کشف شوند. اگر همهٔ کارتها تنها بعد از اسکرول ساخته میشوند و URLهای مکمل ندارند، مسئله فقط تصویر نیست.
برای تصاویر، از src معتبر و متن جایگزین متناسب با خود تصویر استفاده کنید. اتکا به نشانی تصویر در یک ویژگی اختصاصی که فقط بعد از کلیک منتقل میشود، بررسی گوگل را دشوار میکند. در راهنمای سئوی تصاویر جزئیات نام فایل، متن جایگزین و نقش تصویر در صفحه آمده است؛ اینجا تمرکز روی دسترسی خزنده به کارت و URL محصول است.
در فهرست مقالهها هم همین منطق برقرار است. اگر کارت مطلب تازه فقط در صفحهٔ ششم اسکرول ظاهر میشود، باید صفحهٔ ششم قابل باز شدن و لینک مطلب در آن موجود باشد. sitemap میتواند مسیر دیگری برای کشف بدهد، ولی جای ساختار پیمایش داخلی را پر نمیکند. مخاطبی که از یک مقاله به آرشیو برمیگردد نیز باید بتواند جای خود را در فهرست پیدا کند.
پیش از انتشار، چه آزمونهایی انجام دهیم؟
آزمون را از URL صفحهٔ دوم و سوم شروع کنید، نه فقط از صفحهٔ اول. هر URL را در پنجرهٔ ناشناس مستقیم باز کنید و ببینید عنوان، اقلام، لینکهای محصول و راه رفتن به بخشهای مجاور حاضرند یا نه. سپس صفحه را تازهسازی کنید و دکمههای جلو و عقب مرورگر را امتحان کنید. پاسخ HTTP، canonical و robots را نیز برای همان URLها بررسی کنید.
مرحلهٔ بعد، خاموش کردن جاوااسکریپت یا بررسی HTML اولیه است. انتظار نداریم همهٔ انیمیشنها کار کنند؛ هدف این است که مسیر href به بخش بعدی و URL اقلام اصلی از دست نرود. اگر صفحه با رندر سمت کاربر ساخته میشود، علاوه بر HTML اولیه، نسخهٔ رندرشده را هم در URL Inspection سرچ کنسول بررسی کنید. نبودن یک لینک در HTML اولیه لزوماً شکست نیست، ولی در نسخهٔ رندرشده نیز باید مسیر قابل کشف وجود داشته باشد.
در URL Inspection، نشانی بخش دوم را جداگانه تست کنید. ببینید گوگل به صفحه دسترسی دارد، محتوای همان بخش در HTML رندرشده دیده میشود و منابع لازم مسدود نشدهاند. چند محصول از انتهای فهرست را هم بهصورت نمونه بررسی کنید تا مطمئن شوید مسئله فقط روی اقلام دورتر پنهان نمانده است. این آزمون را بعد از هر تغییر مهم در شیوهٔ بارگذاری دوباره انجام دهید.
آزمون موبایل را جدا انجام دهید. ارتفاع صفحه، نحوهٔ نمایش دکمه، بارگذاری تصاویر و تغییر URL ممکن است با دسکتاپ فرق کند. اگر لینک صفحهٔ بعدی فقط در نسخهٔ دسکتاپ چاپ میشود یا در موبایل با یک لایه پنهان میماند، ارزیابی فنی باید همان خروجی موبایل را مبنا بگیرد. این بررسی بخشی از چکلیست سئو تکنیکال است، نه یک تزئین بعد از طراحی.
خطاهای رایجی که در اجرا باید رفع شوند
رایجترین خطا این است که یک button بدون URL جای لینک صفحهٔ بعدی را بگیرد. خطای دوم، تغییر نوار نشانی با History API بدون ساخت صفحهای است که از همان URL مستقیم باز شود. خطای سوم، canonical کردن تمام صفحهها به صفحهٔ اول است، در حالی که هر صفحه اقلام جدا دارد. هر سه خطا با آزمون مستقیم URLها آشکار میشوند.
خطای دیگر، ساخت صفحههای تکراری از ترکیب بیپایان فیلتر، ترتیب نمایش و شمارهٔ صفحه است. اگر همان محصولات زیر دهها URL بسیار مشابه دیده شوند، لازم است سیاست URL و ایندکس جداگانه تعریف شود. برای فهرست اصلی، شمارهٔ صفحه را روشن و پایدار نگه دارید؛ برای فیلترها براساس تقاضا و ارزش صفحه تصمیم بگیرید.
گاهی نیز صفحهٔ بعدی فقط پاسخ API دارد و HTML عمومی ندارد. API برای افزودن کارتها به صفحه مفید است، اما خزنده و کاربر باید بتوانند URL عمومی بخش دوم را مستقل باز کنند. اگر /api/products?offset=20 داده برمیگرداند ولی /category/?page=2 صفحهای قابل استفاده نمیسازد، ساختار پیمایش هنوز کامل نشده است.
آخرین خطای مهم، تکیه به تعداد URLهای ایندکسشده بهعنوان تنها معیار موفقیت است. ممکن است صفحهٔ دوم در گوگل باشد، اما لینک محصولات انتهایی پیدا نشود؛ یا محصولات کشف شوند ولی صفحههای بیارزش فیلتر نیز زیاد شوند. نمونهای از اقلام اول، میانی و انتهایی را بررسی کنید و نتیجه را با دادهٔ خزش، ایندکس و ورودی واقعی بسنجید.
چکلیست تحویل برای تیم توسعه
پیش از تحویل، برای هر بخش فهرست یک URL ثابت، پاسخ مستقیم سالم و محتوای مخصوص همان بخش تعریف کنید. لینک صفحهٔ بعدی باید یک a با href واقعی باشد. لینک هر محصول یا مقاله نیز باید مقصد مستقل داشته باشد. اگر جاوااسکریپت خاموش شد، کاربر باید همچنان بتواند با لینکها میان بخشها حرکت کند.
بعد رفتار اسکرول یا Load More را روی همین ساختار سوار کنید. تغییر URL با History API، تازهسازی صفحه، دکمهٔ بازگشت و وضعیت پایان فهرست را آزمایش کنید. canonical، robots و الگوی پارامترها را برای چند URL نمونه ثبت کنید. در نهایت خروجی رندرشدهٔ گوگل و نسخهٔ موبایل را ببینید و اشکالهای کشف را پیش از انتشار انبوه دستهها برطرف کنید.
جمعبندی
اسکرول بینهایت و Load More زمانی برای جستوجو قابل اتکاترند که تجربهٔ تعاملی روی صفحههای مستقل و لینکهای واقعی ساخته شود. معیار عملی این است: بخشهای بعدی بدون اسکرول، کلیک یا وضعیت قبلی مرورگر هم باید با URL خود باز شوند و راه رسیدن به اقلامشان وجود داشته باشد. پس از اجرا، همین ادعا را با باز کردن مستقیم URLها و بررسی HTML رندرشده در سرچ کنسول بیازمایید.
سوالات متداول
آیا گوگل دکمهٔ «نمایش بیشتر» را کلیک میکند؟
معمولاً نباید کشف محتوا را به کلیک روی دکمه وابسته کنید. گوگل URLهای موجود در لینکهای a دارای href را دنبال میکند؛ بنابراین برای بخشهای بعدی، لینک HTML و URL پایدار لازم است.
آیا باید اسکرول بینهایت را از فروشگاه حذف کنیم؟
خیر. میتوان آن را برای کاربر نگه داشت و در زیر آن، صفحههای مستقل و لینکهای متوالی ساخت. تصمیم دربارهٔ نوع پیمایش باید با تجربهٔ کاربر، کارایی و قابلیت خزش سنجیده شود.
اگر محصولات در sitemap باشند، صفحهبندی لازم نیست؟
sitemap به کشف URL محصول کمک میکند، اما ساختار پیمایش دسته و امکان رسیدن به بخشهای بعدی از داخل سایت را جایگزین نمیکند. هر دو مسیر را جداگانه بررسی کنید.
صفحهٔ دوم را به صفحهٔ اول canonical کنیم؟
اگر صفحهٔ دوم اقلام متفاوتی دارد، canonical همهٔ صفحهها به اول تصمیم پیشفرض مناسبی نیست. URLهای صفحهدار را مستقل بررسی کنید و برای صفحههای قابل ایندکس، canonical سازگار با همان URL بگذارید.
منابع