سئو Headless CMS به قرارداد میان CMS، API، فرانتاند و زیرساخت نیاز دارد. محتوای اصلی و متادیتا را در HTML اولیه تحویل دهید، لینکها را با a و href بسازید، رویداد انتشار را به بازتولید و کش وصل کنید و پیش از deploy، وضعیت HTTP، canonical، robots و schema را خودکار بیازمایید.
در سایت Headless، محتوا در یک CMS نگهداری میشود اما صفحه را فرانتاند دیگری میسازد. این جدایی آزادی فنی میدهد، ولی مسئولیت سئو را میان مدل محتوا، API، مسیرها، رندر و فرایند انتشار پخش میکند. اگر این اجزا قرارداد روشنی نداشته باشند، صفحه برای کاربر درست دیده میشود اما خزنده ممکن است متن، لینک یا متادیتای متفاوتی دریافت کند.
این راهنما برای طراحی همان قرارداد است. تمرکز روی این پرسش عملی قرار دارد که هر فیلد سئو کجا تعریف شود، چه زمانی HTML کامل تحویل داده شود، خطای انتشار چگونه متوقف شود و چه آزمونهایی پیش از انتشار اجرا شوند. بحث به فریمورک خاصی محدود نیست و برای معماریهای React، Vue، Next.js، Nuxt و فرانتاندهای سفارشی قابل استفاده است.
سئو Headless CMS دقیقاً در کدام لایهها شکل میگیرد؟
سئو Headless CMS محصول یک افزونه یا تنظیم منفرد نیست. نتیجه همکاری چهار لایه است: CMS که داده ساختاریافته میدهد، API که آن را منتقل میکند، فرانتاند که HTML و مسیر میسازد و زیرساختی که پاسخ، کش و ریدایرکت را کنترل میکند. شکست هر لایه میتواند خروجی نهایی را ناقص کند.
در CMS باید عنوان، توضیح، canonical، robots، داده ساختاریافته، تصویر اجتماعی و روابط محتوایی مدل شوند. API باید این فیلدها را بدون حذف یا تغییر ناخواسته تحویل دهد. فرانتاند نیز موظف است آنها را در HTML نهایی و در محل درست قرار دهد. سرور یا CDN در پایان باید وضعیت HTTP معتبر، کش قابل پیشبینی و ریدایرکت قطعی بدهد.
اگر طراحی این معماری و مسئولیتهای فنی خارج از توان تیم داخلی است، محدودهٔ خدمات سئو وب باید از ابتدا شامل بازبینی مدل محتوا، قرارداد API، قالب خروجی و آزمون انتشار باشد. اصلاح چند متاتگ پس از راهاندازی، خطاهای ساختاری مسیر و رندر را پوشش نمیدهد.
یک سند مالکیت بسازید و برای هر سیگنال فقط یک صاحب نهایی تعیین کنید. نمونه روشن: تیم محتوا مقدار فیلد را وارد میکند، تیم محصول الزام کسبوکار را تعریف میکند، فرانتاند خروجی HTML را میسازد و تیم سئو آزمون پذیرش را مشخص میکند. این تقسیم، خطا را قابل پیگیری و رفع میکند.
| لایه | خروجی مورد انتظار | خطای رایج | مالک پیشنهادی |
|---|---|---|---|
| CMS | فیلدهای کامل محتوا و سئو | فیلد اختیاری یا بدون اعتبارسنجی | محتوا و محصول |
| API | داده پایدار و نسخهپذیر | حذف فیلد یا پاسخ ناقص | بکاند |
| فرانتاند | HTML قابل ایندکس و مسیر قطعی | وابستگی کامل به اجرای جاوااسکریپت | فرانتاند |
| زیرساخت | وضعیت HTTP، کش و ریدایرکت درست | ۲۰۰ برای صفحه حذفشده یا کش قدیمی | DevOps |
| کنترل کیفیت | تست خودکار و توقف انتشار | آزمون دستی پس از انتشار | سئو و QA |
مدل محتوا را به قرارداد قابل آزمون تبدیل کنید
مدل محتوا باید نیازهای جستوجو را به فیلدهای مشخص و قواعد قابل اندازهگیری تبدیل کند. عبارت مبهم «این صفحه سئو شود» برای توسعه کاربرد ندارد. قرارداد باید نام فیلد، نوع داده، مقدار پیشفرض، محدودیت طول، امکان خالیبودن و رفتار فرانتاند هنگام نبود داده را روشن کند.
برای هر نوع محتوا یک schema مستقل بنویسید. مقاله ممکن است نویسنده، تاریخ انتشار و FAQ داشته باشد، در حالی که صفحه محصول به قیمت، موجودی و شناسه کالا نیاز دارد. استفاده از یک فرم عمومی برای همه انواع صفحه معمولاً فیلدهای بیربط میسازد و داده ضروری بعضی قالبها را از قلم میاندازد.
مقاله سئو سایتهای جاوااسکریپتی محدودیتهای عمومی کشف و رندر محتوا را توضیح میدهد. در معماری هدلس یک گام جلوتر لازم است: همان قواعد باید به قرارداد میان CMS و فرانتاند تبدیل شوند تا هر انتشار، خروجی یکسان و قابل آزمون تولید کند.
در پنل محتوا، پیشنمایش نتیجه جستوجو و پیام خطای دقیق بگذارید. اگر canonical نامعتبر است یا عنوان خالی مانده، انتشار نباید فقط با هشدار زرد ادامه پیدا کند. برای فیلدهای غیرضروری نیز fallback تعریف کنید؛ مثلاً توضیح متا از خلاصه ساخته شود، ولی هرگز robots یا canonical با حدس و بدون قاعده تولید نشود.
مدل رندر را بر اساس نوع صفحه انتخاب کنید
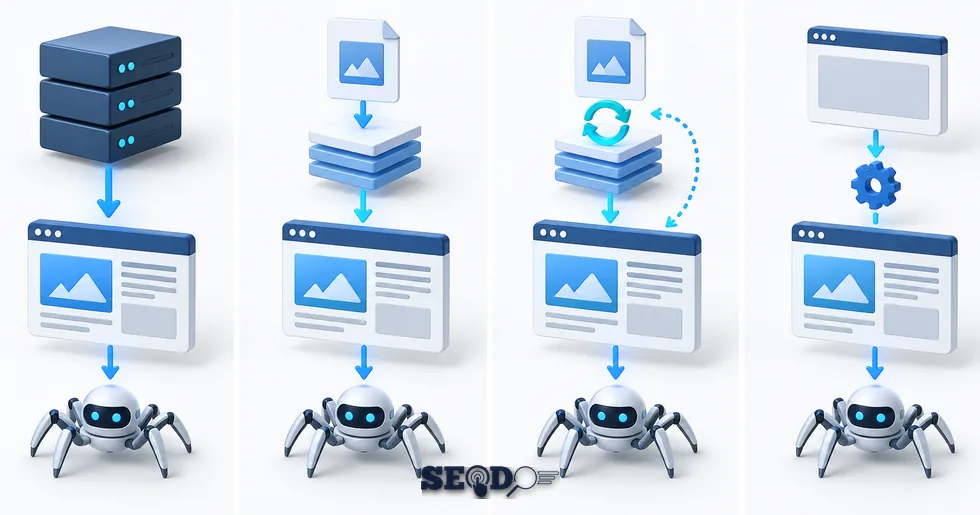
انتخاب میان SSR، SSG، ISR و CSR باید بر پایه تازگی محتوا، تعداد URL، هزینه ساخت، زمان پاسخ و وابستگی به داده لحظهای انجام شود. یک نسخه واحد برای کل سایت لازم نیست. معماری ترکیبی معمولاً منطقیتر است، به شرط آنکه خروجی هر مسیر برای خزنده و کاربر قابل پیشبینی بماند.
در SSR، HTML در هر درخواست یا روی کش سرور ساخته میشود و برای صفحههای شخصینشده عمومی مناسب است. SSG هنگام build خروجی ثابت میسازد و برای محتوای کمتغییر سرعت و ثبات خوبی دارد. ISR یا بازتولید تدریجی، صفحه ثابت را در بازه یا پس از رویداد مشخص تازه میکند و میان تازگی و هزینه ساخت تعادل میسازد.
CSR برای بخشهایی مناسب است که ورود کاربر، تعامل زنده یا داده شخصی دارند. محتوای اصلی صفحه عمومی را به اجرای اسکریپت در مرورگر وابسته نکنید. راهنمای رسمی گوگل میگوید رندر سمت سرور یا پیشرندر برای کاربران و خزندهها ایده خوبی است، زیرا همه رباتها جاوااسکریپت را اجرا نمیکنند و رندر نیز میتواند با تأخیر انجام شود.
رندر داینامیک را طراحی نهایی در نظر نگیرید. گوگل آن را راهکار موقت میداند و SSR، رندر استاتیک یا hydration را توصیه میکند. نگهداری دو خروجی جدا برای ربات و کاربر هزینه و خطر اختلاف محتوا را بالا میبرد. اگر موقتاً استفاده میشود، باید برابری محتوای دو نسخه بهصورت خودکار سنجیده شود.
| روش رندر | کاربرد مناسب | ریسک اصلی | آزمون ضروری |
|---|---|---|---|
| SSR | صفحه عمومی با داده نسبتاً تازه | زمان پاسخ و وابستگی به API | HTML اولیه، خطای API و کش |
| SSG | مقاله و صفحه کمتغییر | قدیمیماندن خروجی تا build بعدی | رویداد انتشار و sitemap |
| ISR | کاتالوگ یا محتوای پرتعداد | فاصله بازتولید و نسخه کششده | revalidation و نسخه صفحه |
| CSR | داشبورد و بخش شخصی | HTML اولیه خالی برای محتوای عمومی | rendered HTML و خطای اسکریپت |
| Hybrid | سایت با قالبهای متفاوت | پیچیدگی قواعد هر مسیر | ماتریس رندر برای همه قالبها |
مسیر، وضعیت HTTP و صفحه خطا را در فرانتاند قطعی کنید
هر محتوای عمومی باید URL مستقل، پایدار و قابل درخواست مستقیم داشته باشد. مسیری که فقط پس از کلیک در برنامه ساخته میشود یا با fragment محتوا را عوض میکند، کشف و اشتراکگذاری را دشوار میکند. قرارداد route باید الگوی URL، منبع slug، زبان، نوع محتوا و رفتار تغییر آدرس را مشخص کند.
صفحه موجود باید ۲۰۰، انتقال دائمی باید ۳۰۱ و محتوای حذفشده باید ۴۰۴ یا ۴۱۰ واقعی برگرداند. نمایش قالب زیبا با کد ۲۰۰ برای محتوای پیدانشده، soft 404 میسازد. خطای API نیز نباید همیشه به صفحه خالی با وضعیت ۲۰۰ تبدیل شود؛ نوع شکست باید به پاسخ HTTP درست نگاشت شود.
برای قواعد انتقال، خطا و مقصدهای تغییرکرده از راهنمای کدهای وضعیت HTTP در سئو استفاده کنید. در Headless بهتر است جدول redirect از CMS یا سرویس مرکزی خوانده شود و پیش از رندر صفحه اعمال شود تا زنجیره، حلقه و انتقال وابسته به جاوااسکریپت ایجاد نشود.
مسیرهای پیشنمایش، پارامترهای داخلی و شناسههای API را از URL عمومی جدا نگه دارید. نسخه preview باید احراز هویت داشته باشد یا noindex قطعی بگیرد و در sitemap یا لینک داخلی ظاهر نشود. برای slug نیز یکتایی، حروف مجاز و رفتار تغییر نام را پیش از ورود داده واقعی تعریف کنید.
rnجزئیات احراز هویت، noindex و آزمون پاسخ را در راهنمای ایمنسازی سئویی محیط آزمایشی بررسی کنید.
rnمتادیتا را در پاسخ اولیه و با یک منبع حقیقت بسازید
عنوان، توضیح متا، canonical، robots و hreflang باید از یک منبع حقیقت تولید شوند و در HTML نهایی فقط یک نمونه معتبر داشته باشند. ترکیب تنظیمات CMS، مقدار پیشفرض قالب و تغییر سمت کاربر میتواند تگهای متناقض بسازد. قرارداد اولویت، مقدار جایگزین و شرایط حذف هر تگ را مکتوب کنید.
برای title و description مقدار پیشفرض قابل کنترل بسازید، اما اجازه دهید صفحه مهم متن اختصاصی داشته باشد. canonical را از route عمومی و دامنه نهایی تولید کنید، نه از URL درخواست با پارامتر. robots نیز باید بر اساس وضعیت انتشار و نوع مسیر تعیین شود؛ محیط staging و preview نباید قاعده خود را به تولید منتقل کنند.
جزئیات انتخاب مقصد canonical و خطاهای چندتگی در مقاله تگ کنونیکال آمده است. در سایت هدلس، آزمون باید هم سورس پاسخ اولیه و هم DOM رندرشده را بخواند؛ مقدار canonical نباید پس از hydration به نشانی دیگری تغییر کند.
گوگل توصیه میکند canonical در HTML قرار گیرد. اگر ناچارید آن را با جاوااسکریپت اضافه کنید، نباید مقدار اولیه را به مقصد دیگری عوض کنید. همچنین noindex در HTML اولیه را با جاوااسکریپت حذف نکنید؛ ممکن است موتور جستوجو پس از دیدن noindex از رندر صرفنظر کند و تغییر بعدی را نبیند.
لینک داخلی را با HTML واقعی و داده رابطهای بسازید
منو، بردکرامب، فهرست دسته، صفحهبندی و پیشنهادهای مرتبط باید لینک HTML واقعی بسازند. گوگل معمولاً لینکی را مطمئن میخزد که عنصر a با ویژگی href معتبر باشد. رویداد onClick روی div یا دکمه، حتی اگر برای کاربر مسیر را باز کند، قرارداد قابل اتکایی برای کشف URL نیست.
در CMS فقط فهرست URL ذخیره نکنید. رابطه معنایی میان محتواها را مدل کنید تا ویراستار صفحه مقصد را انتخاب کند و فرانتاند نشانی canonical آن را بسازد. این روش جلوی لینک شکسته پس از تغییر slug را میگیرد و اجازه میدهد صفحات مرتبط، والد و فرزند یا محصول مکمل با قاعده مشخص نمایش داده شوند.
برای طراحی ساختار و انتخاب متن لینک، راهنمای لینکسازی داخلی را مبنا قرار دهید. در Headless باید افزون بر ارتباط موضوعی، وجود href در خروجی اولیه، دسترسی مقصد، یکتایی URL و حضور لینک در نسخه موبایل نیز در تست خودکار بررسی شود.
صفحهبندی و بارگذاری بیشتر را فقط به اسکرول یا کلیک وابسته نکنید. هر بخش باید URL قابل خزش و لینک بعدی یا قبلی داشته باشد. فیلترها نیز باید فهرست کنترلشدهای از URLهای قابل ایندکس بسازند؛ تولید ترکیبهای نامحدود از پارامترها میتواند خزش را روی صفحههای کمارزش پخش کند.
داده ساختاریافته باید با محتوای قابل مشاهده برابر باشد
Structured data را میتوان از فیلدهای CMS ساخت، اما نوع schema باید با قالب صفحه و محتوای دیدهشده تطابق داشته باشد. اگر نام، قیمت، نویسنده یا پرسشها در JSON-LD با صفحه فرق کنند، خطا فقط فنی نیست؛ قرارداد داده بین CMS و فرانتاند شکسته و باید انتشار متوقف شود.
برای هر نوع محتوا نگاشت جدا بسازید و فیلد اجباری schema را به فیلد واقعی CMS وصل کنید. دادهای که در صفحه وجود ندارد با مقدار فرضی پر نشود. در نسخه چندزبانه نیز زبان، URL و مقادیر محلی باید از همان locale صفحه بیایند، نه از تنظیم سراسری یا کش نسخه پیشین.
قواعد و نمونههای مناسب صفحه محصول در مقاله اسکیما محصول و ریچ ریزالت بررسی شدهاند. در معماری هدلس، همان قواعد باید به تست build یا pipeline تبدیل شوند تا JSON نامعتبر، نوع ناسازگار یا داده قدیمی پیش از رسیدن به محیط اصلی شناسایی شود.
اعتبار نحوی کافی نیست. خروجی را با Rich Results Test، HTML رندرشده و داده visible مقایسه کنید. اگر صفحه پس از hydration داده دیگری نشان میدهد، schema اولیه نیز باید مطابق نسخه نهایی باشد. نسخهبندی schema در کنار نسخه API کمک میکند تغییر یک فیلد، بیخبر چند قالب را خراب نکند.
کش، بازتولید و نقشه سایت را به رویداد انتشار وصل کنید
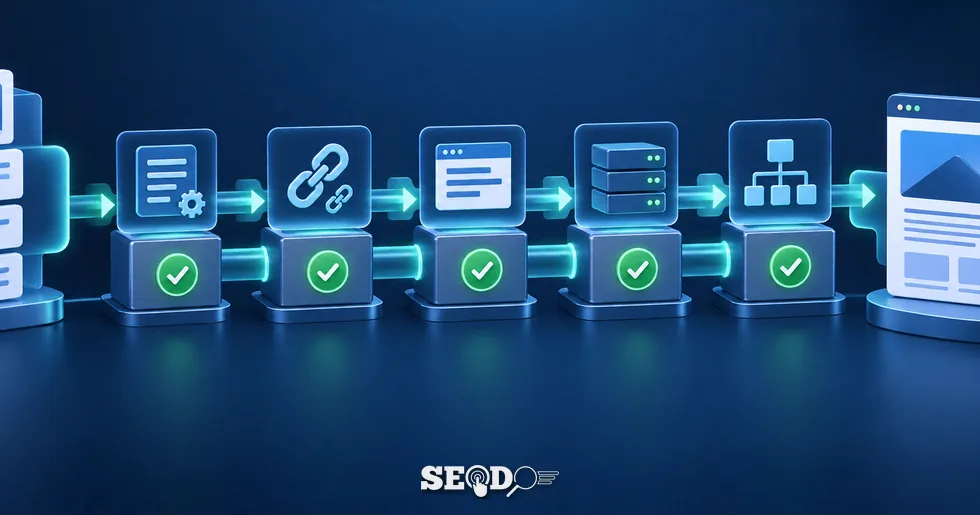
در معماری هدلس، زدن دکمه انتشار پایان کار نیست. محتوا باید در API در دسترس شود، کش CDN پاک یا تازه شود، صفحه استاتیک بازتولید شود و نقشه سایت تاریخ معتبر بگیرد. اگر این زنجیره شکسته باشد، CMS وضعیت «منتشرشده» نشان میدهد اما کاربر و خزنده نسخه قدیمی را میبینند.
برای هر رویداد publish، update، unpublish و slug change یک webhook تعریف کنید. پیام باید شناسه محتوا، نوع، locale، URL قدیم و جدید و زمان نسخه را حمل کند. مصرفکننده نیز پاسخ و retry کنترلشده داشته باشد. اجرای موفق webhook را در CMS نمایش دهید تا ویراستار از وضعیت واقعی خروجی خبر داشته باشد.
برای ممیزی گستردهتر نقشه سایت، robots، canonical و الگوهای خزش به چکلیست سئو تکنیکال مراجعه کنید. در Headless نکته اصلی هماهنگی این خروجیها با نسخه محتواست؛ sitemap نباید URLی را معرفی کند که هنوز رندر یا کش عمومی آن آماده نشده است.
یک شناسه نسخه در پاسخ یا header داخلی نگه دارید تا بتوان نسخه CMS، API و صفحه را مقایسه کرد. این شناسه برای کاربر نمایش داده نمیشود، اما هنگام خطا روشن میکند کدام لایه عقب مانده است. بدون آن، پاککردن مکرر کش جای تشخیص علت را میگیرد و مسئله ممکن است دوباره برگردد.
کارایی را بدون پنهانکردن محتوای اصلی بهبود دهید
Headless بهخودیخود سایت سریع نمیسازد. درخواستهای زنجیرهای API، bundle سنگین، hydration طولانی و تصویرهای بزرگ میتوانند LCP و INP را خراب کنند. بهینهسازی باید از مسیر بحرانی شروع شود: HTML اولیه، فونت و تصویر اصلی، CSS لازم و کمترین جاوااسکریپت برای تعامل نخست.
دادههای ضروری بالای صفحه را در سرور یا build دریافت کنید و درخواستهای فرعی را به بعد موکول کنید. از waterfall میان چند API جلوگیری کنید و زمان timeout و fallback داشته باشید. اگر سرویس جانبی کند شد، محتوای اصلی و لینکها باید همچنان در پاسخ باقی بمانند؛ شکست ابزار پیشنهاددهنده نباید کل صفحه را خالی کند.
اندازهگیری را برای هر قالب جدا انجام دهید. میانگین کل سایت نشان نمیدهد صفحه مقاله یا محصول کجا کند شده است. داده آزمایشگاهی را با داده کاربران واقعی مقایسه کنید و نسخه deploy را کنار آن ثبت کنید. هدف فقط امتیاز ابزار نیست؛ باید زمان دریافت محتوای اصلی و پاسخ تعامل پایدار شود.
قواعد کش را بر اساس تازگی و ریسک انتخاب کنید. فایلهای نسخهدار میتوانند کش طولانی بگیرند، ولی HTML و پاسخ API به revalidation نیاز دارند. headerهای اشتباه ممکن است صفحه خصوصی یا نسخه noindex را عمومی کنند. ماتریس کش باید مسیر، TTL، کلید، purge و fallback را مشخص کند.
کنترل کیفیت را پیش از انتشار و پس از استقرار اجرا کنید
QA در سایت هدلس باید دو سطح داشته باشد: آزمون قرارداد پیش از build و آزمون خروجی پس از deploy. سطح اول فیلدهای اجباری، ساختار API و قواعد route را بررسی میکند. سطح دوم HTML واقعی، وضعیت HTTP، canonical، robots، لینکها، تصاویر و داده ساختاریافته را روی نشانی نهایی میسنجد.
یک مجموعه URL نماینده برای هر قالب، زبان و وضعیت محتوا نگه دارید. صفحه منتشرشده، پیشنویس، حذفشده، تغییر slug، صفحهبندی و خطای API باید نمونه داشته باشند. تست فقط روی صفحه موفق، مسیرهای شکست را پوشش نمیدهد. برای deploy پرریسک، مقایسه HTML نسخه فعلی و نسخه جدید تغییر ناخواسته را زود آشکار میکند.
روند کامل آزمون تکصفحه و معیار پذیرش در راهنمای کنترل کیفیت سئو آمده است. در پروژه Headless این کنترل باید به pipeline متصل شود و خطاهای حیاتی مانند canonical متفاوت، noindex ناخواسته یا نبود لینک اصلی بتوانند انتشار را متوقف کنند.
پس از deploy نیز smoke test اجرا کنید. کد پاسخ، یک H1، عنوان و canonical یکتا، تعداد لینک قابل خزش، schema معتبر، تصویر اصلی و حضور محتوا در HTML اولیه بررسی شوند. نتیجه آزمون همراه با نسخه build ذخیره شود تا خطای بعدی به انتشار مشخص برگردد و rollback سریع انجام شود.
| گیت انتشار | معیار قبولی | در صورت شکست |
|---|---|---|
| مدل محتوا | فیلدهای اجباری و نوع داده معتبر | توقف انتشار در CMS |
| API | پاسخ کامل با نسخه سازگار | توقف build یا fallback ثبتشده |
| HTML اولیه | محتوا، H1، متا و لینک اصلی حاضر | توقف deploy |
| مسیر و HTTP | وضعیت و redirect مطابق سناریو | اصلاح route یا edge rule |
| پس از deploy | canonical، robots، schema و تصاویر سالم | rollback یا hotfix |
مانیتورینگ را از نسخه محتوا تا HTML نهایی ادامه دهید
پس از راهاندازی، فقط uptime را نبینید. خطای webhook، زمان build، نسبت پاسخ API ناموفق، صفحههای با HTML خالی، canonical متناقض و رشد soft 404 باید پایش شوند. هر هشدار باید شناسه نسخه، قالب اثرپذیر، نمونه URL و مالک بررسی داشته باشد تا تیم از نمودار به اقدام برسد.
لاگ edge و سرور برای فهم رفتار خزنده و خطاهای رندر مفید است. تغییر الگوی پاسخ ۵۰۰، افزایش زمان تولید HTML یا افت درخواستهای Googlebot در یک بخش میتواند نشانه خرابی مسیر باشد. این دادهها را با Search Console و زمان deploy کنار هم ببینید؛ همزمانی به تنهایی علت را ثابت نمیکند.
در داشبورد، سلامت فنی را از عملکرد جستوجو جدا اما مرتبط نمایش دهید. کاهش کلیک ممکن است از تقاضا یا رتبه باشد، در حالی که افت همزمان HTML کامل و URLهای ایندکسشده احتمال خطای معماری را بیشتر میکند. ثبت تغییرات CMS، API و فرانتاند زمان تشخیص را کوتاه میکند.
برای هر رخداد مهم یک مرور کوتاه انجام دهید: کدام قرارداد شکست، چرا تست آن را نگرفت و چه مانعی از تکرار جلوگیری میکند. پاسخ ممکن است افزودن فیلد اجباری، تست جدید، تغییر ترتیب deploy یا هشدار نسخه باشد. بستن رخداد بدون اصلاح فرایند، همان خطا را به قالب دیگری منتقل میکند.
نقشه اجرای سئو Headless CMS را مرحلهای پیش ببرید
پیادهسازی را با فهرست صفحات حیاتی و انواع محتوا شروع کنید، سپس قرارداد داده و مسیر را بنویسید. بعد مدل رندر هر قالب، متادیتا، لینکها و رویدادهای انتشار را تعیین کنید. آزمون خودکار و مانیتورینگ باید پیش از مهاجرت کامل آماده شوند، نه پس از مشاهده افت ایندکس.
در مهاجرت، چند URL نماینده را بهصورت آزمایشی روی معماری جدید منتشر کنید و HTML اولیه، DOM رندرشده، وضعیت HTTP و داده Search Console را بسنجید. سپس دامنه را بهتدریج گسترش دهید. انتقال همزمان همه قالبها، تشخیص منبع خطا و برگشت به نسخه سالم را دشوار میکند.
- نوعهای محتوا، URLهای حیاتی و مالک هر لایه فهرست شدهاند.
- فیلدهای title، description، canonical، robots و داده ساختاریافته قرارداد دارند.
- برای هر قالب، روش رندر و رفتار خطای API مشخص است.
- هر صفحه عمومی URL مستقل و وضعیت HTTP واقعی دارد.
- منو، بردکرامب، صفحهبندی و پیشنهادهای مرتبط با a و href ساخته میشوند.
- رویدادهای انتشار، بازتولید، purge و sitemap به هم متصلاند.
- تست پیش از build و smoke test پس از deploy اجرا میشوند.
- نسخه CMS، API و فرانتاند در رخدادها قابل ردیابی است.
- مهاجرت با گروه آزمایشی و امکان rollback انجام میشود.
- مانیتورینگ فنی و عملکرد جستوجو پس از انتشار ادامه دارد.
معیار پایان پروژه، بالا آمدن صفحه در مرورگر نیست. باید بتوانید برای هر URL پاسخ دهید محتوا از کدام نسخه آمده، کدام روش رندر آن را ساخته، canonical و robots کجا تعیین شدهاند، چه تستی انتشار را تأیید کرده و در صورت خطا چه کسی پاسخ میدهد. این شفافیت، معماری هدلس را قابل نگهداری میکند.
جمعبندی
سئو Headless CMS زمانی پایدار میشود که محتوا، API، رندر و زیرساخت یک قرارداد مشترک داشته باشند. HTML اولیه باید محتوای اصلی، متادیتای یکتا و لینکهای واقعی را تحویل دهد؛ route و وضعیت HTTP باید قطعی باشند و انتشار نیز بازتولید صفحه، کش و sitemap را هماهنگ کند. تست خودکار پیش از استقرار و مانیتورینگ نسخه پس از آن، خطا را پیش از افت گسترده ایندکس یا ترافیک آشکار میکنند.
سوالات متداول
آیا Headless CMS ذاتاً برای سئو بهتر است؟
خیر. Headless انعطاف معماری و کنترل بیشتری میدهد، اما نتیجه به مدل محتوا، روش رندر، مسیرها و فرایند انتشار بستگی دارد. سایتی که HTML اولیه ناقص، لینکهای غیرقابل خزش یا canonical متناقض دارد میتواند با وجود فناوری جدید عملکرد ضعیفی در جستوجو داشته باشد.
برای صفحات عمومی SSR بهتر است یا SSG؟
انتخاب به تازگی داده و تعداد صفحات بستگی دارد. SSG برای محتوای کمتغییر خروجی سریع و پایدار میسازد. SSR برای داده تازه یا وابسته به درخواست مناسبتر است. ISR میتواند میان این دو تعادل بسازد. معیار اصلی، تحویل HTML کامل و بهروزرسانی قابل پیشبینی است.
آیا گوگل محتوای CSR را ایندکس میکند؟
گوگل میتواند جاوااسکریپت را رندر کند، اما رندر مرحله جداگانه دارد و همه رباتها نیز جاوااسکریپت را اجرا نمیکنند. برای محتوای عمومی اصلی، رندر سمت سرور یا پیشرندر انتخاب مطمئنتری است. خروجی واقعی باید با URL Inspection و HTML رندرشده بررسی شود.
canonical و robots را در CMS ذخیره کنیم یا فرانتاند بسازد؟
CMS میتواند تصمیم و مقدار اختصاصی را نگه دارد، اما فرانتاند باید خروجی معتبر را در HTML بسازد. برای مقدار پیشفرض، قرارداد اولویت لازم است. canonical از URL عمومی و robots از وضعیت انتشار ساخته میشود و هر دو باید پیش و پس از hydration یکسان بمانند.
مهمترین تست پیش از انتشار سایت هدلس چیست؟
یک تست واحد کافی نیست. حداقل باید وضعیت HTTP، محتوای HTML اولیه، یک H1، title، canonical، robots، لینکهای a با href، تصاویر، structured data و رفتار صفحه حذفشده بررسی شوند. این آزمونها برای هر قالب نماینده اجرا و خطاهای حیاتی باید مانع deploy شوند.
منابع
- Google Search Central: Understand JavaScript SEO Basics
- Google Search Central: Link Best Practices
- Google Search Central: Dynamic Rendering as a Workaround